Smart Grid Data Fabric
Il data layer per analytics, AI ed energia
Le soluzioni data-driven funzionano solo se i dati sono affidabili, accessibili e utilizzabili.
Smart Grid Data Fabric collega dispositivi, storage, trasformazioni e applicazioni in un’unica architettura aperta, progettata per i sistemi energetici.
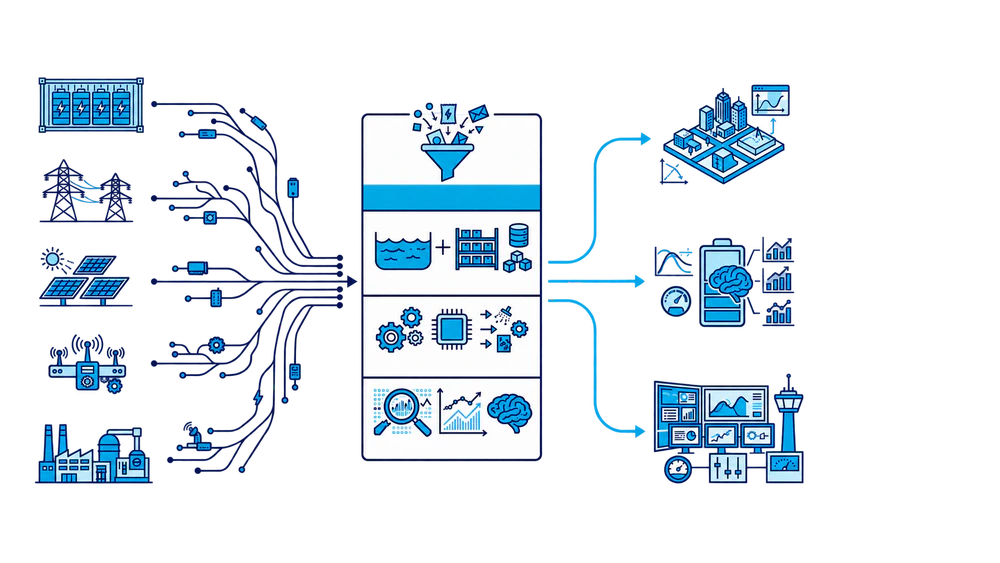
Percorso del dato
Dal dato grezzo all’applicazione
Un unico flusso collega le sorgenti sul campo agli strumenti che utilizzano i dati.
Ingestion & Streaming
Acquisisce dati batch e streaming provenienti da BESS, sensori, sistemi energetici e altre sorgenti, rendendoli disponibili in modo coerente all’interno della piattaforma.
Analytical Lakehouse Storage
Conserva dati storici e operativi in formati analitici aperti e indipendenti dal fornitore, creando una base comune per elaborazioni, query e applicazioni.
Data
Transformation
Trasforma i dati grezzi e disomogenei in dataset coerenti e documentati, pronti per essere utilizzati dalle applicazioni analitiche, dalle dashboard e dai servizi.
Analytical Query Engine
Permette di interrogare e analizzare grandi volumi di dati direttamente sul layer analitico, riducendo spostamenti, copie e duplicazioni non necessarie.
Analytics & Exploration
Rende dati curati e documentati disponibili a dashboard, applicazioni analitiche e modelli di machine learning e intelligenza artificiale, senza duplicarli.
Dimostrazione
Guardalo in azione
Dal dato acquisito sul campo alla query analitica: Smart Grid Data Fabric rende accessibile in un unico ambiente l’intero percorso del dato.
Sovranità dei dati
I dati sono un asset. Il loro valore cresce quando restano sotto il tuo controllo.
Chi gestisce sistemi energetici produce ogni giorno un patrimonio di dati. Il problema non è generarli, ma riuscire a conservarli, comprenderli e riutilizzarli senza perdere controllo e indipendenza tecnologica. Smart Grid Data Fabric nasce per dare al proprietario dei dati gli strumenti per valorizzarli mantenendo sovranità, portabilità e trasparenza.
Open source
Nessun costo di licenza
Il core della piattaforma utilizza tecnologie open source, riducendo i costi ricorrenti del data layer e lasciando libertà di evoluzione tecnologica.
Nessun lock-in
Standard e formati aperti
I dati rimangono accessibili attraverso tecnologie e formati aperti, evitando che il patrimonio informativo dipenda da un singolo fornitore.
End-to-end
Tutto ciò che serve, senza complessità inutile
Ingestion, storage, trasformazione, query e analytics convivono in un’architettura compatta, evitando di sovrapporre servizi non necessari.
Portabile
Cloud, on-premise o ibrido
La containerizzazione permette di eseguire la stessa architettura in cloud, sull’infrastruttura del cliente o in configurazioni ibride.
Auditabile
Tracciabilità, immutabilità e trasparenza
Dati e processi possono essere gestiti in modo tracciabile e verificabile.
Multi-nodo
Scalabilità e sovranità dei dati
Più nodi possono cooperare per distribuire i carichi oppure mantenere i dati vicino al luogo in cui vengono prodotti.
Architettura
Scalabilità orizzontale e data federation
Un’architettura multi-nodo non serve soltanto a gestire più dati: permette di scegliere dove eseguire il calcolo e dove mantenere il dato.
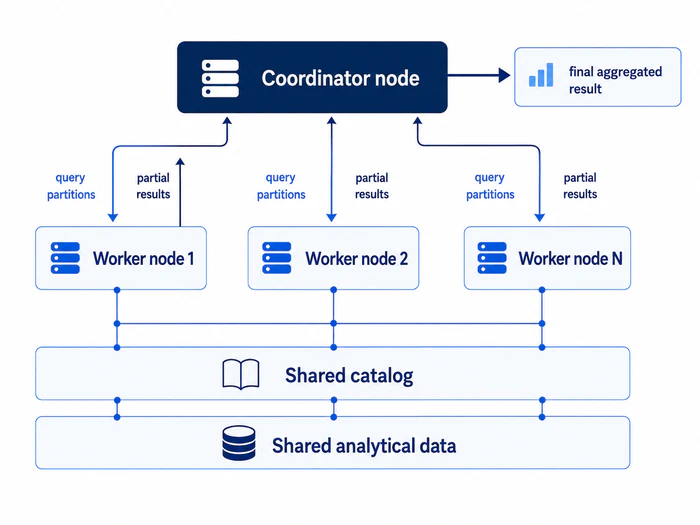
Scalabilità orizzontale
Crescere aggiungendo risorse
Quando volumi e carichi aumentano, nuovi nodi possono essere aggiunti per distribuire le elaborazioni e aumentare progressivamente la capacità del sistema.
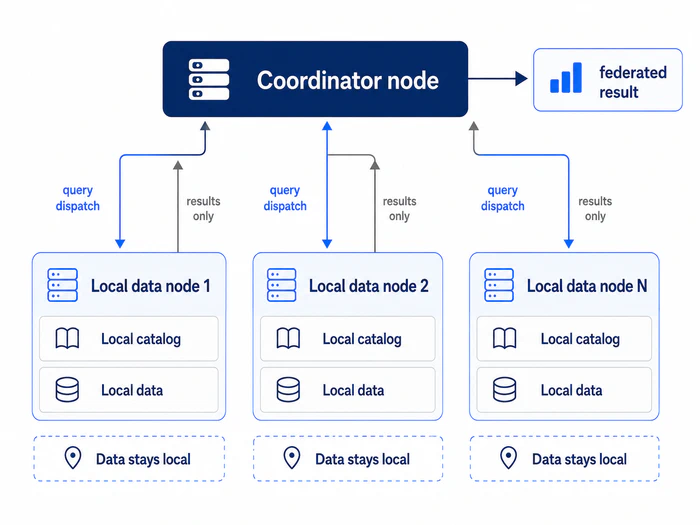
Data federation
I dati possono restare dove vengono prodotti
Siti o organizzazioni differenti possono mantenere localmente i propri dati e renderli disponibili in modo controllato, costruendo una vista federata senza imporre la centralizzazione.
Prestazioni
Prestazioni elevate con risorse contenute
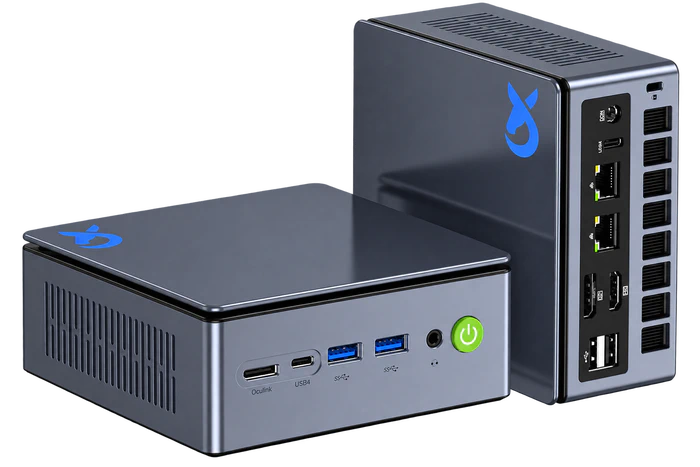
Un’infrastruttura dati efficiente non dovrebbe richiedere hardware sovradimensionato per svolgere attività analitiche ordinarie. Smart Grid Data Fabric utilizza tecnologie analitiche moderne e formati colonnari per sfruttare in modo efficiente CPU, memoria e storage, rendendo possibile eseguire workload significativi anche su hardware compatto. Sotto il cofano, Smart Grid Data Fabric utilizza DuckDB, motore OLAP open source progettato per analytics ad alte prestazioni direttamente sui dati, con continuità e indipendenza del progetto tutelate dalla DuckDB Foundation.
Hardware utilizzato
CPU: Ryzen 7 PRO 6850U
CPU type: 8 core / 16 thread
RAM: 32 GB DDR5
Storage: 1 TB NVMe
Dimensions: 132×125×58 mm
Benchmark TPC-H
Scale factor: SF100
Dataset: ~26 GB - 22 queries
Tempo complessivo: ~200 s
Latenza mediana: ~7 s
Limite memoria: 8 GB
Costruiamo una base dati che rimanga tua
Dall’acquisizione sul campo alle applicazioni analitiche, Smart Grid Data Fabric permette di costruire un’infrastruttura aperta intorno ai dati del tuo sistema energetico.
Parliamo della tua infrastruttura dati